对冲基金数据库架构:面向时点公开记录的双时态模式设计
深入探讨对冲基金另类数据数据库的架构设计,解耦实际交易日期与公开时间戳,消除跨越850,000+条已解析公开事件的前视偏差(look-ahead bias)。
在量化资产管理领域,为非传统数据集构建机构级对冲基金数据库(hedge fund database)是系统化研究团队面临的核心工程挑战之一。当标准化行情数据和财务会计报表遵循固定披露节奏时,来自政府法定披露、联邦采购行动和立法备案的另类数据却以异步、非均匀的渠道抵达。构建能够摄取这些数据流且不引入回测扭曲的基础设施,需要严格的双时态数据架构。
当定量研究人员从公开披露中构建预测性股票因子时,传统关系模型无法捕捉监管分发的时间细微差异。就地覆盖已修改记录、忽略法定发布延迟或将历史交易映射到当前母公司实体,都会引入严重的前视偏差和幸存者偏差。要了解量化研究台如何构建机构数据摄取流程,请参阅关于面向对冲基金的另类数据(Alternative Data for Hedge Funds)的参考框架。有关另类数据源的对比评估,请参阅我们关于另类数据源的深度分析以及获得政府合同的无人机公司中的联邦供应商积压分析。
现代对冲基金为何需要双时态数据库架构
现代对冲基金数据库架构必须解决一个根本的时间问题:市场参与者只能根据历史上特定时刻可公开获取的信息执行交易。在学术文献和基础数据管道中,工程师通常仅依赖单个日期列,通常标记为 event_date 或 transaction_date。然而在联邦采购和法定披露中,机构合同官员签署行动的日期几乎从未在同一天出现在法定采购门户中。
以联邦采购领域为例,航空航天、国防和信息技术主承包商的年度采购规模超过7500亿美元。当国防部向主承包商授予重大合同修改时,法定运营安全规则要求在联邦记录中公布之前至少有90天的公布延迟。如果量化回测引擎使用合同签署日期而非经过验证的公布时间戳来连接股票价格序列,回测将提前90天消耗市场当时无法获取的信息。
双时态数据库架构通过显式跟踪每个独立观察值的两个独立时间轴来消除此缺陷:
- 有效时间(Valid Time / Business Time): 经济或合同事件在物理世界中发生的具体日期和时间(例如合同授予日期或交易执行日期)。
- 事务时间(Transaction Time / Ingestion Time): 摄取引擎在公开披露被验证、解析并存储在数据库中时记录的不可变时间戳。
通过在超过850,000个已解析公开事件的历史库中实施双时态索引,量化模型可以在任何历史时点精确重建全球企业情报状态。要检查上市公司的历史时间映射规模,量化研究人员可以查阅公开的机构数据覆盖门户。
双时态模式如何解耦事件日期与公开时间戳
将有效时间与事务时间解耦需要不可变存储模式。在传统运维数据库中,当机构发布对先前合同修改的更正或官员修改年度披露时,系统会执行 UPDATE 语句覆盖现有表数据。在量化对冲基金数据库中,严禁就地更新。每个修改、取消或更正均作为独立的仅追加(append-only)行摄取,并带有专属有效范围:system_from 和 system_to。
| 公开记录数据集 | 有效事件日期 | 公开延迟中位数 | 第90百分位延迟 | 基础法定机制 |
|---|---|---|---|---|
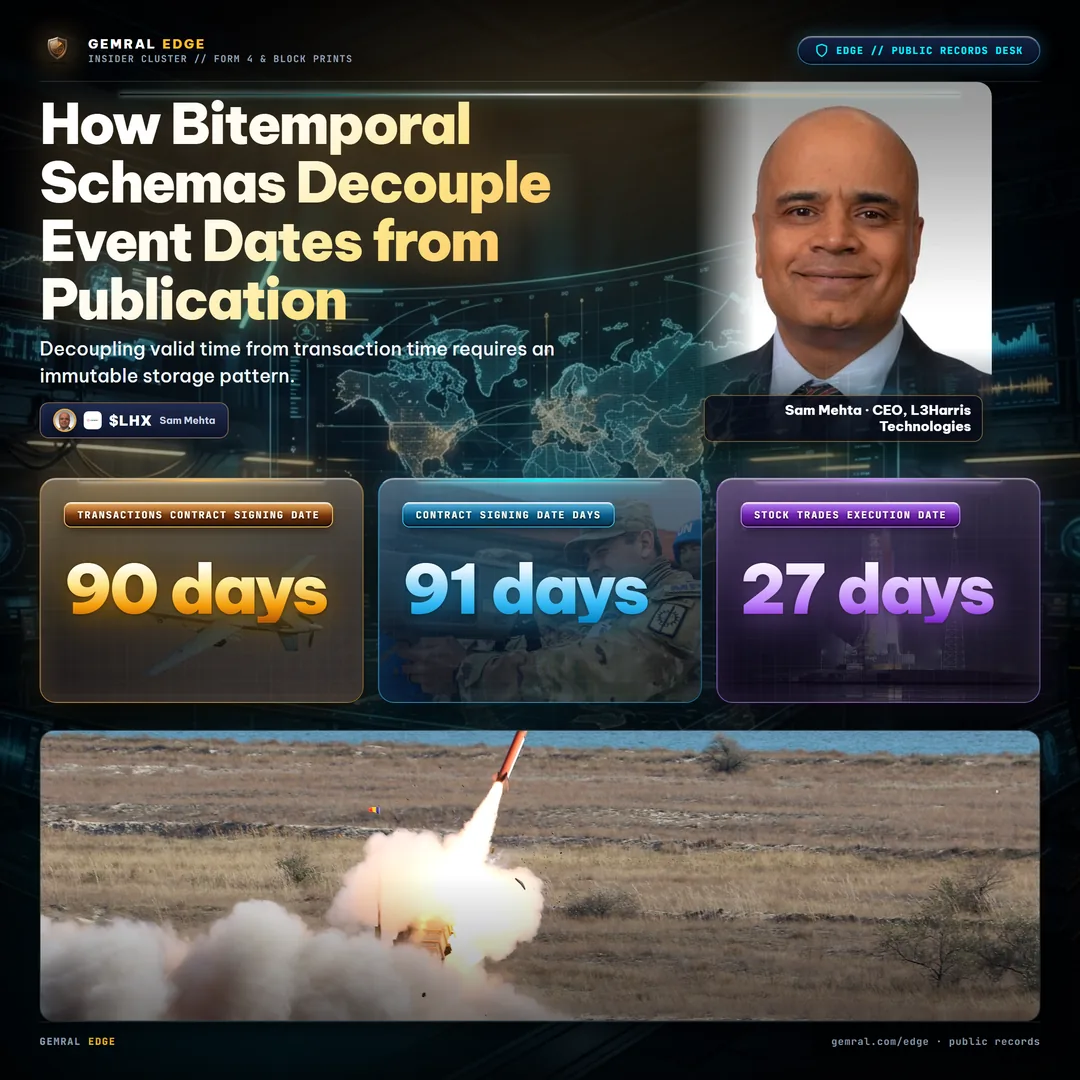
| 国防采购合同交易 | 合同签署日期 | 90天 | 91天 | 法定90天作战安全禁运 |
| 国会议员股票交易 | 交易执行日期 | 27天 | 63天 | 《STOCK法案》45天法定备案窗口 |
| 企业内部人交易申报 | 交易执行日期 | 1天 | 4天 | 内部人持股变动2个工作日内法定报告要求 |
| 季度游说披露 | 季度结束日期 | 20天 | 21天 | 《游说披露法》季度末20天申报规则 |
| 民事机构采购 | 行动发生义务日期 | 3天 | 14天 | 联邦采购机构批量上传周期 |
报告延迟的经验分布凸显了双时态模式分离的操作必要性。在超过50,000条国会交易披露和35,000条企业内部人备案中,交易执行与公开披露之间存在显著差距。在国会股票交易中,交易日期与法定披露之间的中位延迟为27天,第90百分位达到63天。同样,根据《游说披露法》,季度游说报告在每历季度结束后有20天的中位延迟。
在国防采购中,对9,158份双重跟踪国防合同的经验测量表明,每日合同公告比联邦合同登记早中位数90天,涉及1.07万亿美元已宣布总额。对于系统化量化模型而言,在发布时间戳上执行时点连接可确保零前视偏差,保证投资组合再平衡完全反映历史执行约束。
代码变更与并购中的时点实体解析
双时态时间戳解决了时间泄漏问题,而时点实体解析则解决了企业身份碎片化问题。上市公司不是单一孤岛,而是通过复杂的子公司、合资企业和运营分支体系赢得政府业务、雇佣游说者并管理物理基础设施。大型航天国防巨头可能维持超过350个活跃的商业与政府实体CAGE代码及子公司标识符。
商业供应商数据源的核心工程缺陷在于将所有历史交易静态映射到当前母公司。这种静态关系方法将合并后实体的收入和合同归功于并购前多年的收购方,严重扭曲历史回测。
为了精确衡量静态实体映射引入的失真,请查看联邦合同交易的审计结果:
- 当前表映射错误: 将已解析的联邦合同交易映射到今天的母公司表而非发布当天的有效母公司,会导致896亿美元(占2.7万亿美元的3.3%,涉及8,568笔交易)被错误归属于其他股票代码。
- 并购完成后的交易延续: 正好有659笔联邦合同在并购完成前签署但在交易完成后才公布。在经过审计的双时态管道中,651笔归入上市收购方,8笔因收购方未上市而不带股票代码。
- 股票代码变迁: 共有254笔合同由在签署与公布之间更改股票代码的企业执行。时点解析器可在记录公开当天准确关联有效交易代码。
- 多层子公司跳转: 关联到股票代码的合同交易中有1,919亿美元(占金额的7.1%,涉及13,465笔交易)仅能通过带生效日期的子公司关系链匹配到上市公司。主合同上的受赠方并非上市母公司名称。
回顾RTX Corporation、L3Harris Technologies和General Dynamics等国防巨头的企业演变。当联合技术公司(United Technologies)于2020年与雷神公司(Raytheon Company)合并成立雷神科技(后更名为RTX)时,授予传统子公司的合同需要具备时序感知的母公司链接。通过静态母公司表连接历史事件会错误地将现代企业规模投射到历史交易时期。研究人员可直接通过公开门户验证按代码划分的历史记录:RTX Corporation 披露遥测 (gemral.com/edge/s/RTX),以及同行国防档案 L3Harris Technologies 遥测 (gemral.com/edge/s/LHX) 和 General Dynamics 遥测 (gemral.com/edge/s/GD)。
静态SQL快照与不可变双时态Parquet数据湖仓
构建机构对冲基金数据库需要选择能够支撑PB级模拟查询的底层存储架构。传统的关系数据库管理系统(RDBMS)采用行式存储布局,在对数十万历史企业事件执行时序区间连接时开销巨大。
| 架构指标 | 关系型SQL快照 | 双时态Parquet数据湖仓 | 量化研究优势 |
|---|---|---|---|
| 存储格式 | 行式关系表 | 列式Apache Parquet文件 | 8x至12x压缩比与向量化列式扫描 |
| 时间查询机制 | 带有BETWEEN子句的复杂SQL自连接 | 按公布日期分区的快照路径 | 零扫描分区裁剪极速回测 |
| 记录可变性 | 就地UPDATE和DELETE查询 | 仅追加不可变记录版本控制 | 加密SHA-256清单验证 |
| API与批量导出 | 受连接数限制的直接数据库连接 | 高吞吐量REST API和预构建数据包 | 确定性批量摄取到本地计算集群 |
| 幸存者偏差处理 | 退市股票常被清除以节省空间 | 历史标的池完整保留(包含已退市名称) | 在4,745个历史股票代码上准确模拟 |
在生产研究工作流程中,机构量化基金正从事务型SQL实例转向列式湖仓架构。将另类数据以标准Apache Parquet格式存储带来了显著的计算优势。Parquet的列式压缩允许量化引擎仅扫描必要的数值列(如 action_amount、event_published_at 和 ticker_asof),同时跳过数百兆的描述性文本元数据。
此外,通过利用时序分区裁剪组织Parquet目录(例如按发布年份和月份分区),回测计算集群可在毫秒内完成历史跨度的时间旅行查询。量化研究人员可以直接通过 Edge Data Preview 存储库查看验证样本行和模式定义。
数据完整性关卡:消除摄取过程中的前视与幸存者偏差
数据架构的可靠性取决于执行其摄取管道的质量关卡。在另类数据工程中,管道必须在任何批次提交到分析湖仓之前实施机械验证关卡。依赖供应商自我声明或随意的清洗规则会引入潜在错误,削弱量化模型效果。
为了维持机构级数据标准,我们的工程管道在数据集发布前对所有传入的公共记录进行双盲精确度抽样检查,并对照原始公共源文档。在最新的验证批次中,所有13种主要记录类型的精确度得分均在95.6%至100%之间:
- 联邦采购合同: 98.5%精度(196条中193条对照原始采购文件验证无误)。
- 国会议员股票交易: 97.7%精度(172条中168条验证无误;28条因源网站自动化访问限制而无法核对)。
- 企业游说注册: 96.0%精度(200条中192条对照立法申报记录验证无误)。
- 预中标采购通知: 97.0%精度(198条中192条对照联邦招标公告验证无误)。
- 投标抗议诉讼: 97.0%精度(200条中194条对照行政法庭案卷验证无误)。
全面透明度要求披露历史数据集构建的累计精确度得分。由于早期管道版本是在2026年10月高级实体解析器部署前评级的,因此所有历史批次的累计精确度在四个类别中表现较低(合同91.2%、预中标公告76.4%、分包商链接94.0%、投标抗议92.5%)。
此外,量化研究人员必须考虑覆盖边界。自2018财年以来的联邦采购合同金额中,约有49.3%链接到上市交易代码。剩余50.7%流向私营企业、非营利组织、大学研究实验室或未在公开股票市场交易的外国实体。在投标抗议中,共追踪13,850起抗议,其中25.3%(3,505起)正式链接至合同交易与受赠方代码,61.7%符合法定100天的裁决截止日期。
将联邦采购遥测接入系统化交易管道
一旦主要另类数据集组织入不可变双时态数据库,量化工程师便可将这些纯净数据流接入系统化量化研究工作流。现代量化团队通过三种互补的交付机制使用另类数据:
- 机构样本数据包与批量Parquet: 进行初步量化评估的研究台通常摄取标准化Parquet归档。覆盖300个核心股票标的的完整样本包包含跨越158个Parquet文件和24个关系表的786,636行数据,并配有证明行级完整性的加密清单。
- 可编程REST API: 生产执行算法通过高吞吐量REST API同步运行状态,在法定市场收盘后的预定间隔拉取经过验证的增量数据流。
- 交互式分析研究终端: 主观量化投资组合经理和研究分析师通过专用情报终端审视企业风险敞口、合同积压消耗速度和监管备案。
对于评估另类数据流的量化基金、对冲基金数据工程师和机构资产配置者,Gemral Edge提供涵盖零售研究、专业分析和企业数据交付的透明接入层级。要探索个人和企业研究访问权限,请查看Gemral Edge 定价与方案规格,透明定价涵盖从39美元/月的Pro层到299美元/月的B2B研究台,以及2,000美元/月的机构API层级。
Frequently asked questions
What is a bitemporal hedge fund database architecture?
A bitemporal database tracks two timeline dimensions simultaneously: valid time (when an event occurred in the real world) and transaction time (when the record was ingested into the system). For hedge funds, this ensures backtests only execute trades using information available at that exact historical moment, preventing look-ahead bias.
How does point-in-time entity resolution work in alternative data pipelines?
Point-in-time entity resolution maps awards, filings, and disclosures filed under diverse subsidiary names, vendor codes, or historical ticker symbols to the exact public equity ticker active on the publication date, accurately accounting for corporate spin-offs, mergers, and ticker renames.
Why do traditional relational SQL snapshots fail for quantitative simulation?
Traditional relational databases typically overwrite revised records in place. When federal agencies retroactively correct contract figures or companies submit amended disclosures, in-place updates create retroactive leakage in historical simulations, leading to false statistical significance during backtesting.
What data formats and delivery standards do institutional quant funds require?
Institutional quantitative funds require immutable, columnar Apache Parquet files partitioned by publication date, accompanied by cryptographic SHA-256 manifests, row-level verification ledgers, and high-throughput REST APIs for seamless backtesting and production ingestion.