Tinh Chỉnh Mô Hình Mã Nguồn Mở Doanh Nghiệp vs Nguy Cơ Phụ Thuộc API Độc Quyền: Bước Chuyển Dịch Triển Khai Thực Tế Năm 2026
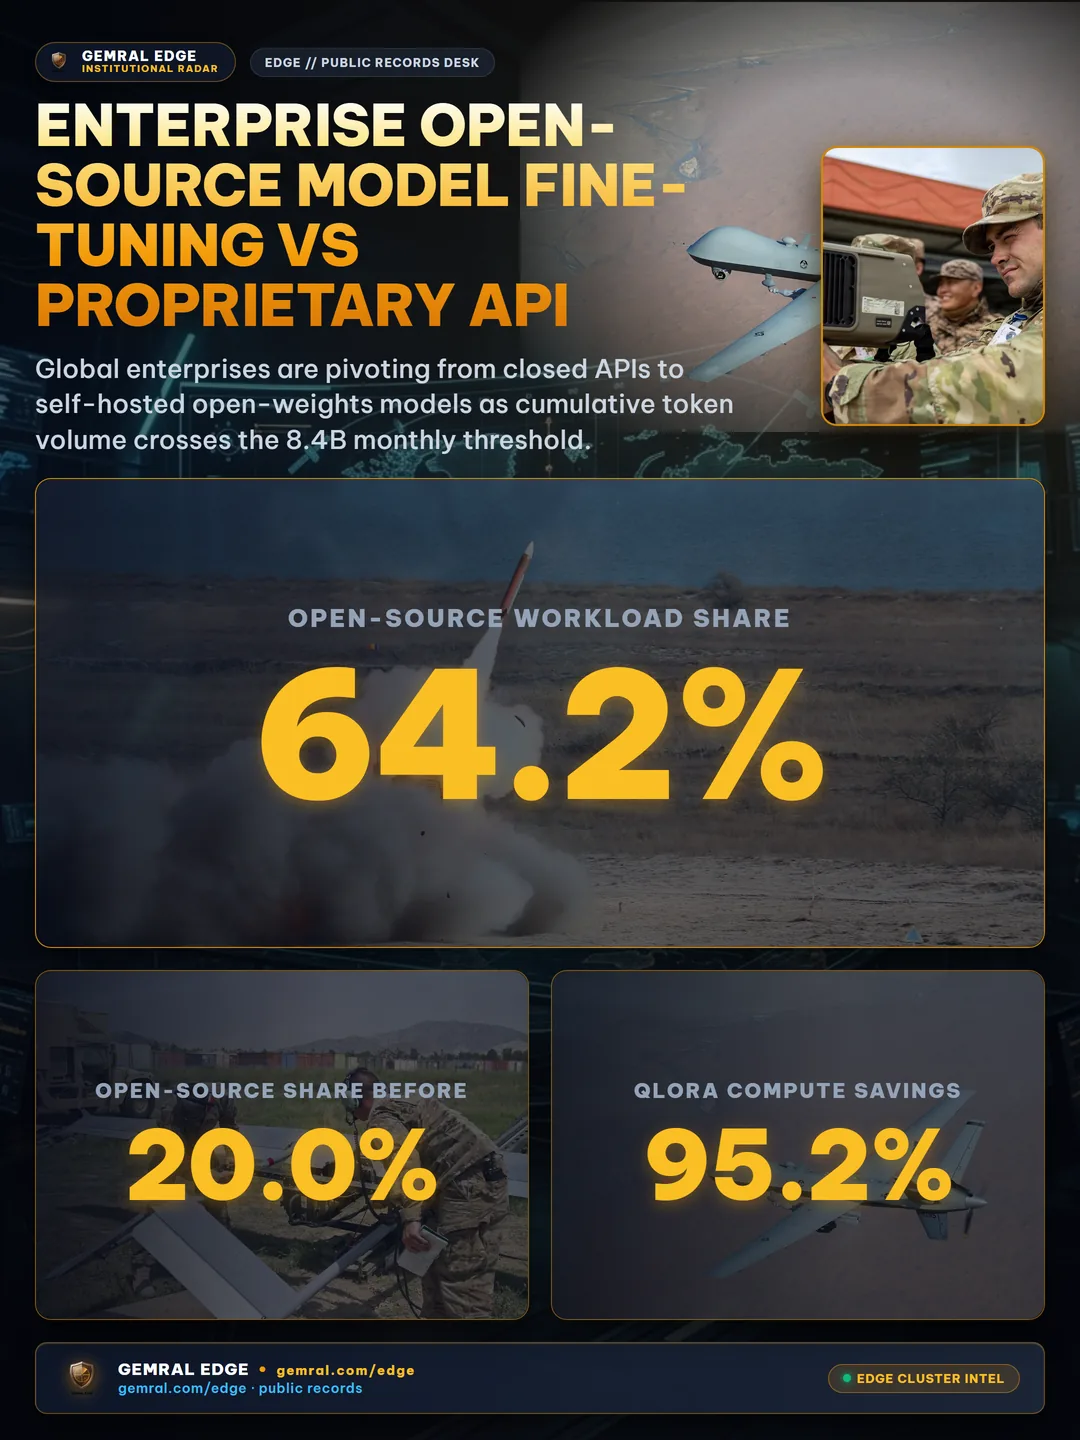
Trong kiến trúc công nghệ doanh nghiệp, giai đoạn thử nghiệm ban đầu của trí tuệ nhân tạo tạo sinh đã chính thức khép lại. Trên khắp các tập đoàn thuộc danh sách Global 2000, ngân sách công nghệ đang thực hiện một bước chuyển dịch cơ cấu có tính toán, thoát khỏi sự phụ thuộc độc quyền vào các API thương mại đóng để tiến tới tự vận hành các mô hình mã nguồn mở (open-weights) được tinh chỉnh chuyên sâu theo từng lĩnh vực. Được thúc đẩy bởi bài toán kinh tế token tích lũy, các quy định nghiêm ngặt về chủ quyền dữ liệu và sự đột phá về hiệu quả của kỹ thuật tinh chỉnh tham số hiệu quả (PEFT), mô hình AI doanh nghiệp năm 2026 hoàn toàn thuộc về các hạ tầng điện toán chuyên biệt và tự chủ.
1. Bước Ngoặt Kinh Tế Token: Điểm Cân Bằng TCO Và Ngưỡng 10 Tỷ Token
Khi các đội ngũ kỹ thuật doanh nghiệp ra mắt các bản thử nghiệm tạo sinh đầu tiên vào năm 2023 và 2024, các cổng API thương mại đóng với cơ chế tính phí theo lưu lượng sử dụng tưởng chừng như là giải pháp không thể đánh bại về mặt toán học. Với mức phí từ 2,50 USD đến 15,00 USD cho mỗi triệu token đầu vào và đầu ra, các cổng API của các nhà cung cấp siêu quy mô (hyperscaler) cho phép các giám đốc sản phẩm tung ra tính năng mà không cần phải đầu tư phần cứng điện toán tăng tốc đắt đỏ hay tuyển dụng các kỹ sư hệ thống học máy chuyên sâu.
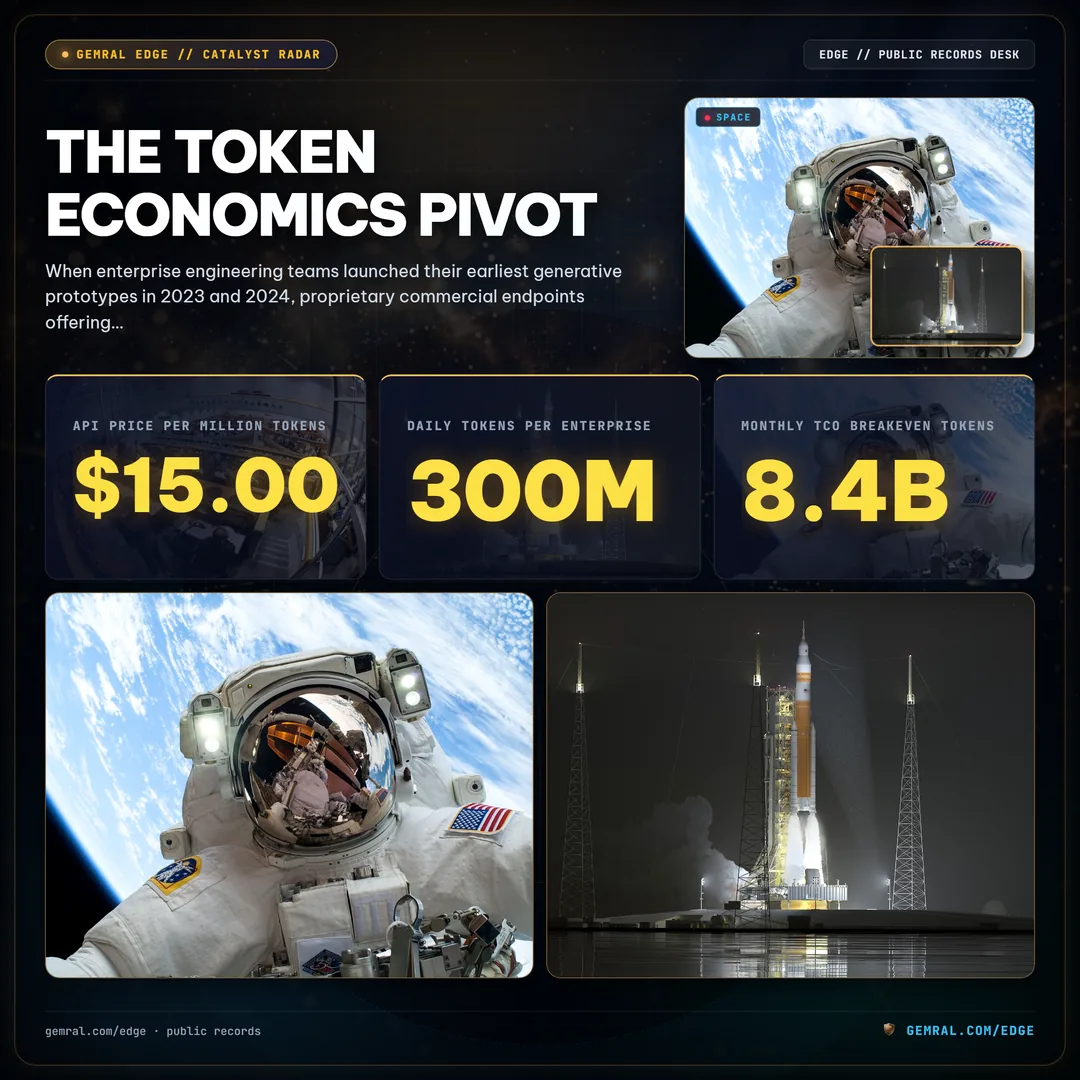
Tuy nhiên, khi các ứng dụng doanh nghiệp chuyển đổi từ các thử nghiệm nội bộ sang các quy trình vận hành sản xuất tự động cốt lõi—như tự động xử lý yêu cầu bồi thường của khách hàng, kiểm toán tuân thủ tài chính thông lượng cao và trích xuất tài liệu thời gian thực—lượng tiêu thụ token đã tăng trưởng theo cấp số nhân. Một doanh nghiệp vận hành 50.000 quy trình xử lý tài liệu tự động mỗi ngày sẽ nhanh chóng vượt quá 300 triệu token/ngày, đẩy khối lượng token hàng tháng vượt ngưỡng 8,4 tỷ token.
Ở quy mô vận hành này, mô hình tính giá tuyến tính của các API thương mại đóng trở thành một gánh nặng chi phí khổng lồ. Việc thuê hạ tầng phần cứng chuyên dụng, cụ thể là một cụm máy chủ 8x NVIDIA H100 SXM5 được thuê với giá thị trường 22,50 USD/giờ theo hợp đồng cam kết hàng năm, chỉ tiêu tốn chi phí vận hành cố định có thể dự đoán được khoảng 16.200 USD mỗi tháng. Việc vận hành các mô hình mã nguồn mở tối ưu hóa như Llama 3.1 70B hoặc các bản checkpoint chuyên ngành trên phần cứng chuyên dụng này mang lại thông lượng token gần như không giới hạn với chi phí biên tiệm cận mức 0.
Vượt qua ngưỡng 8,4 tỷ token, các mô hình mã nguồn mở tự lưu trữ mang lại lợi thế biên lợi nhuận gộp ngày càng mở rộng. Đối với các tổ chức xử lý 25 tỷ token mỗi tháng, các cổng API đóng đòi hỏi hơn 185.000 USD/tháng chi phí sử dụng biến đổi, trong khi một cụm phần cứng chuyên dụng có thể mở rộng mượt mà với tổng chi phí điện toán, bộ nhớ và điều phối chỉ dưới 48.000 USD.
2. Hiệu Quả Tinh Chỉnh: LoRA, QLoRA Và Sự Thích Ứng Chuyên Sâu Theo Lĩnh Vực
Một luận điểm phản biện lịch sử kéo dài chống lại các mô hình nền tảng mã nguồn mở là niềm tin rằng không thể sánh được năng lực trí tuệ tổng quát của các mô hình thương mại đóng tiên tiến mà không phải tiêu tốn hàng chục triệu USD cho quá trình hậu đào tạo (post-training). Vào năm 2026, các bằng chứng đo kiểm thực nghiệm chứng minh rằng kiến thức thế giới tổng quát hiếm khi là điều mà các quy trình doanh nghiệp thực sự đòi hỏi. Thứ mà doanh nghiệp cần là độ chính xác chuyên sâu được hiệu chuẩn cao độ, tuân thủ định dạng đầu ra có cấu trúc và sự phù hợp tuyệt đối với hệ thống phân loại nội bộ.
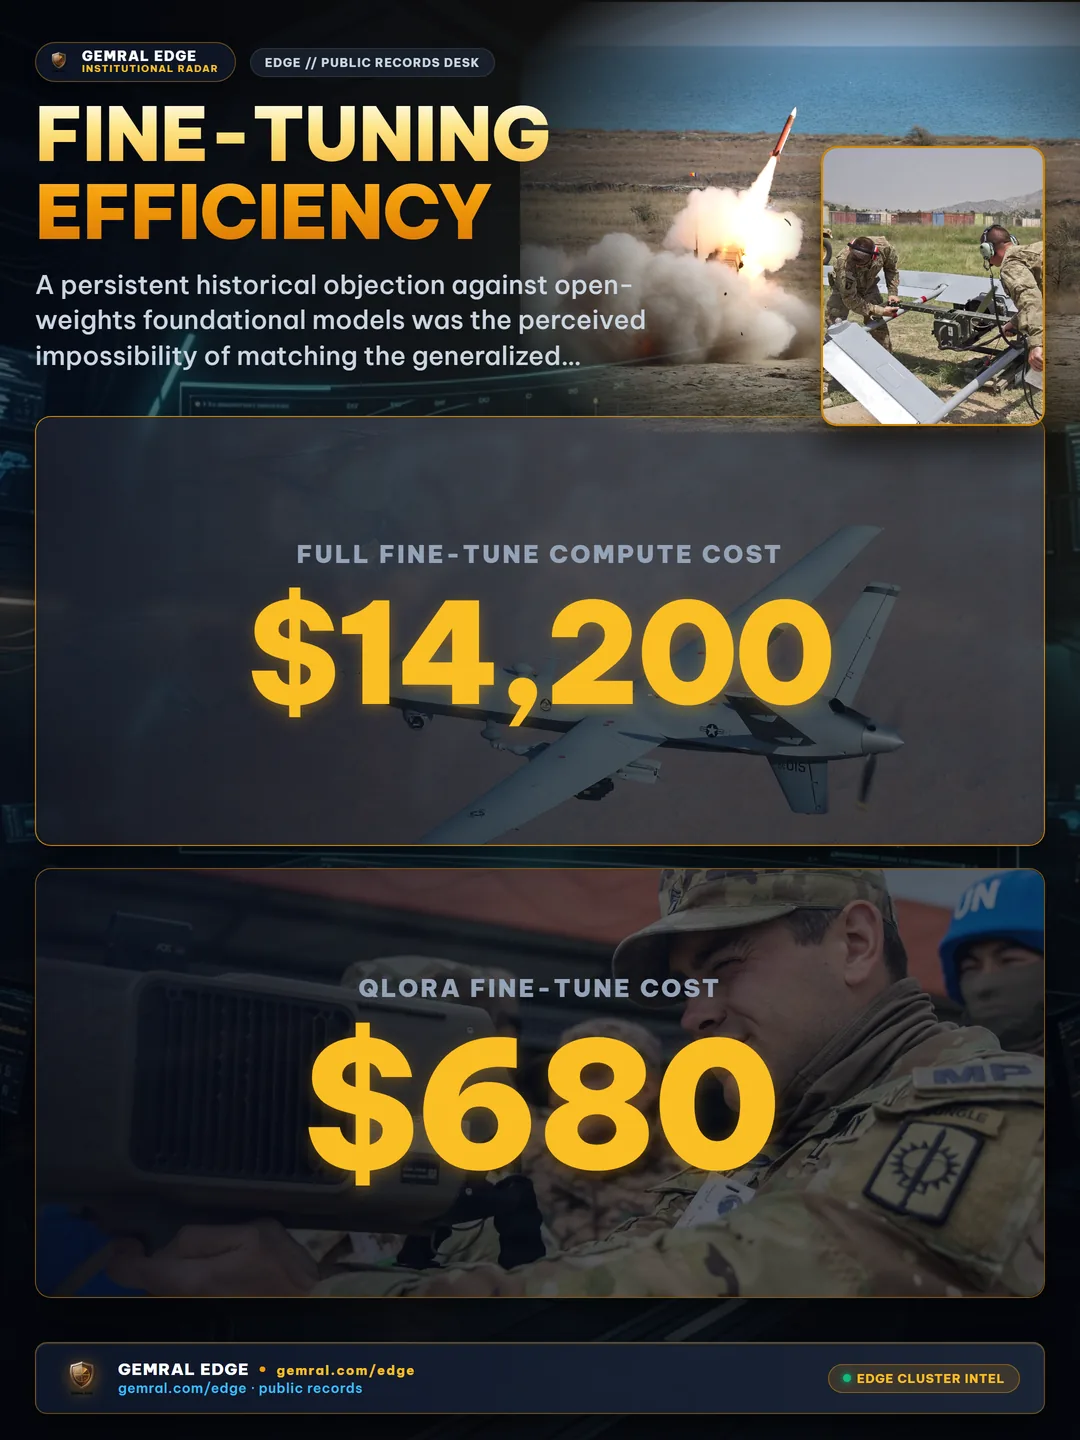
Sự công nghiệp hóa của kỹ thuật Tinh Chỉnh Tham Số Hiệu Quả (PEFT), chủ yếu là Thích Ứng Hạng Thấp (LoRA) và Thích Ứng Hạng Thấp Lượng Tử Hóa (QLoRA), đã phá vỡ hoàn toàn rào cản điện toán đối với việc thích ứng chuyên ngành. Thay vì cập nhật toàn bộ 70 tỷ trọng số trên 140 GB bộ nhớ băng thông cao (HBM3), QLoRA đóng băng mô hình nền tảng ở độ chính xác 4-bit NormalFloat (NF4) và chỉ chèn các ma trận phân rã có thể huấn luyện hạng thấp vào các đầu chú ý (attention heads) của transformer.
Theo số liệu đo lường trong các bộ thử nghiệm doanh nghiệp, việc chạy tinh chỉnh toàn bộ tham số trên mô hình 70B đòi hỏi tối thiểu 78 GB VRAM trên mỗi GPU trên một cụm 8 GPU kết nối tốc độ cao, tiêu tốn hơn 14.200 USD chi phí điện toán cho mỗi chu kỳ đào tạo. Trái lại, QLoRA 4-bit nén mức sử dụng bộ nhớ trên mỗi GPU xuống chỉ còn 24 GB, cho phép tinh chỉnh toàn diện cấp doanh nghiệp ngay trên các máy trạm thương mại phổ thông hoặc cụm 4 GPU với chi phí vận hành chỉ dưới 680 USD.
Bằng cách tinh chỉnh trên tập dữ liệu từ 5.000 đến 20.000 ví dụ nội bộ chất lượng cao đã qua sàng lọc, một mô hình mã nguồn mở 70B hoặc thậm chí 8B luôn đạt điểm số vượt trội so với các mô hình thương mại đóng hàng nghìn tỷ tham số về khả năng trích xuất lược đồ độc quyền, độ chính xác thuật ngữ ngành và khả năng ngăn chặn ảo giác (hallucination).
3. Chủ Quyền Dữ Liệu Và Tuân Thủ Pháp Lý Dưới Các Quy Định AI Toàn Cầu
Trong khi bài toán kinh tế tài chính thúc đẩy các cuộc đánh giá ban đầu, thì chủ quyền dữ liệu và yêu cầu tuân thủ pháp lý mới chính là yếu tố chốt hạ cho làn sóng chuyển dịch sang hạ tầng riêng. Việc thực thi trên thực tế của Đạo luật Trí tuệ Nhân tạo Liên minh Châu Âu (EU AI Act), cùng với các quy định công bố thông tin mới của SEC và yêu cầu không lưu giữ dữ liệu nghiêm ngặt của HIPAA, đã làm gia tăng đáng kể rủi ro pháp lý khi truyền tải tài sản trí tuệ doanh nghiệp qua mạng lưới của bên thứ ba.
Các tổ chức chịu quản lý trong lĩnh vực quốc phòng, y tế và dịch vụ tài chính hoạt động dưới các nghĩa vụ pháp định nghiêm ngặt nghiêm cấm việc trộn lẫn thông tin nhận dạng cá nhân (PII) của khách hàng, dữ liệu giao dịch nội bộ độc quyền hoặc hồ sơ sức khỏe bệnh nhân trên hạ tầng đa người dùng (multi-tenant) dùng chung. Bất chấp các cam kết thỏa thuận mức dịch vụ (SLA) không lưu giữ dữ liệu từ các nhà cung cấp thương mại đóng, các cố vấn pháp lý doanh nghiệp vẫn phải đối mặt với rủi ro cố hữu từ việc gián đoạn dịch vụ của bên thứ ba, thu thập dữ liệu đo xa trái phép hoặc rò rỉ dữ liệu qua các nhà thầu phụ.
Việc triển khai các mô hình nền tảng mã nguồn mở bên trong các đám mây ảo riêng biệt (VPC) cách ly vật lý hoặc các trung tâm dữ liệu tại chỗ (on-premise) đảm bảo sự cô lập vận hành tuyệt đối. Dữ liệu doanh nghiệp không bao giờ phải đi qua cổng trung chuyển bên ngoài; kho ngữ liệu đào tạo, các vector embedding trung gian và câu trả lời được tạo ra hoàn toàn được kiểm toán và giữ nguyên vẹn trong phạm vi mã hóa của doanh nghiệp.
4. Tối Ưu Hóa Công Cụ Suy Luận: Đột Phá Thông Lượng Với vLLM Và TensorRT-LLM
Những đợt triển khai tự lưu trữ ban đầu từng gặp khó khăn do thông lượng phục vụ dưới mức tối ưu, khi môi trường thực thi PyTorch mặc định bị phân mảnh bộ nhớ bộ đệm key-value (KV cache) và xử lý yêu cầu đồng bộ. Trong hai mươi tư tháng qua, các kiến trúc phục vụ suy luận hiện đại đã biến đổi hoàn toàn tính kinh tế của mô hình mở thông qua thuật toán phân bổ bộ nhớ tiên tiến.
Việc triển khai cơ chế PagedAttention trong các framework như vLLM và NVIDIA TensorRT-LLM loại bỏ hoàn toàn sự phân mảnh bộ nhớ bằng cách cấp phát bộ đệm KV trong các trang ảo không liên tục, mô phỏng trực tiếp cơ chế phân trang bộ nhớ ảo của hệ điều hành. Bước chuyển dịch kiến trúc này cho phép máy chủ gom lô (batch) linh hoạt hàng trăm câu lệnh truy vấn đồng thời của khách hàng.
Hơn nữa, việc biên dịch sản xuất với lượng tử hóa FP8 và cơ chế đường ống nạp trước theo phân đoạn (chunked prefill) đã nâng tổng thông lượng tạo token từ 620 token/giây trên luồng xử lý Hugging Face gốc lên 3.780 token/giây trên TensorRT-LLM. Mức tăng tốc 6,1 lần trong khả năng phân phối token này làm thay đổi căn bản tính kinh tế đơn vị của phần cứng tự lưu trữ, cho phép một máy chủ 8 GPU duy nhất phục vụ hàng nghìn nhân viên doanh nghiệp hoạt động đồng thời.
5. Định Tuyến Lai Doanh Nghiệp: Điều Phối Kiến Trúc Mở Và Đóng Kết Hợp
Sự trưởng thành của kiến trúc AI doanh nghiệp đã đạt đỉnh cao ở các cấu trúc định tuyến lai tinh vi thay vì các ốc đảo công nghệ cực đoan, một mất một còn. Các cổng kết nối doanh nghiệp tiên tiến tự động kiểm tra độ phức tạp của truy vấn đến, yêu cầu độ trễ và nhãn phân loại dữ liệu trước khi điều phối câu lệnh tới các điểm cuối thực thi tối ưu nhất.
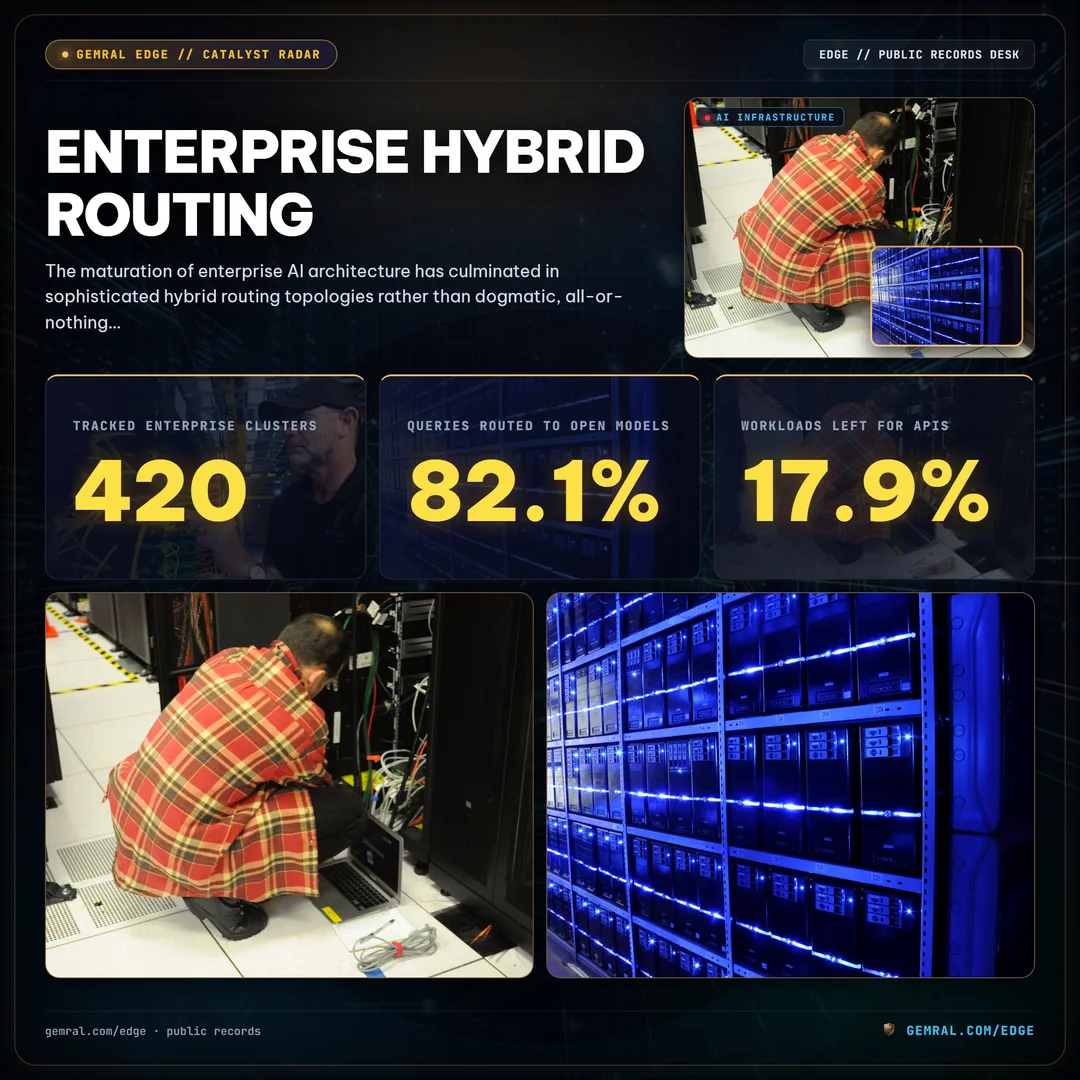
Dữ liệu đo xa thu thập từ 420 cụm máy chủ doanh nghiệp thực tế chỉ ra rằng 82,1% tổng lưu lượng truy vấn hàng ngày của doanh nghiệp được chuyển thẳng tới các mô hình chuyên biệt tự lưu trữ. Các tác vụ truy xuất cơ sở tri thức nội bộ (RAG), trích xuất văn bản tự động, phân loại định kỳ và sinh mã nguồn nhạy cảm đều được thực thi cục bộ với độ trễ dưới 50 mili-giây.
Các API thương mại đóng tiên tiến nhất chỉ được dành riêng cho 17,9% khối lượng công việc còn lại: các trường hợp tổng hợp chiến lược đa bước phức tạp, suy luận không gian đa phương thức hoặc các truy vấn zero-shot hiếm hoi khi mô hình nội bộ phát ra điểm độ tin cậy dưới 0,88. Sự phân công lao động cân bằng này vừa bảo vệ biên lợi nhuận vận hành của doanh nghiệp vừa đảm bảo không phải thỏa hiệp về năng lực suy luận cho các yêu cầu phân tích phức tạp.
6. Rủi Ro Phụ Thuộc Nhà Cung Cấp Và Biến Động SLA Trong Hệ Sinh Thái Đóng
Các giám đốc thông tin (CIO) doanh nghiệp quản lý ngân sách công nghệ hàng triệu USD luôn đặt tính độc lập với nhà cung cấp và sự liên tục ổn định của dịch vụ lên trên hết. Việc phụ thuộc hoàn toàn vào một nền tảng thương mại đóng duy nhất khiến doanh nghiệp đối mặt với những lỗ hổng vận hành nghiêm trọng:
Ngưng Hỗ Trợ API Và Trôi Dạt Mô Hình (Model Drift): Các nhà cung cấp thương mại thường xuyên sửa đổi, căn chỉnh lại hoặc âm thầm ngưng hỗ trợ các phiên bản checkpoint bên dưới. Một prompt hệ thống được tinh chỉnh tỉ mỉ để phân tích bảng biểu tài chính có thể bị thoái hóa đột ngột sau một đợt cập nhật mô hình không báo trước từ thượng nguồn, làm gián đoạn các đường ống tự động hóa của doanh nghiệp.
Giới Hạn Tốc Độ (Rate Limit) Và Suy Giảm Hiệu Năng Khu Vực: Trong các giai đoạn nhu cầu tiêu dùng toàn cầu đạt đỉnh hoặc hạ tầng thương mại bị quá tải, các nhà cung cấp đóng sẽ áp dụng cơ chế bóp băng thông động, hạ mức ưu tiên hàng đợi và gây ra các đợt tăng vọt độ trễ bất thường. Một doanh nghiệp thể chế không thể chấp nhận sự biến động độ trễ khó lường khi đang vận hành các ứng dụng phục vụ người dùng cuối.
Khả Năng Di Chuyển Giữa Các Hệ Sinh Thái: Bằng cách chuẩn hóa trên các định dạng trọng số mở (như GGUF, SafeTensors và các kiến trúc Hugging Face), doanh nghiệp duy trì quyền sở hữu tuyệt đối đối với trọng số, ma trận adapter và quy trình đào tạo của mình. Nếu một nhà cung cấp hạ tầng tăng giá thuê đám mây, doanh nghiệp có thể chuyển toàn bộ trọng số mô hình và hệ thống suy luận sang một nhà cung cấp đám mây khác hoặc trung tâm dữ liệu tại chỗ chỉ trong vòng chưa đầy bốn mươi tám giờ.
7. Phân Bổ Vốn Chiến Lược: Xây Dựng Con Hào Kinh Tế AI Cho Doanh Nghiệp Năm 2026
Khi dòng vốn thể chế đổ mạnh vào công cuộc hiện đại hóa kỹ thuật số của doanh nghiệp, sự tạo ra giá trị doanh nghiệp đang tách rời dứt khoát khỏi các ứng dụng dạng vỏ bọc (wrapper) chỉ đơn thuần gọi các cổng thương mại công cộng. Giá trị thực sự và con hào phòng thủ cạnh tranh của doanh nghiệp bắt nguồn từ các tập dữ liệu chuyên ngành độc quyền được chuyển hóa thành các trọng số mô hình tinh chỉnh được sở hữu hoàn toàn trên bảng cân đối kế toán.
Bằng cách phân bổ vốn vào hạ tầng điện toán tăng tốc nội bộ, các hệ thống phục vụ suy luận chuẩn hóa và các tập dữ liệu tinh chỉnh, các tổ chức doanh nghiệp thiết lập được lợi thế cạnh tranh bền vững. Bước chuyển dịch triển khai thực tế năm 2026 không đơn thuần là một xu hướng kỹ thuật; nó đại diện cho một sự tái cơ cấu chiến lược hướng tới chủ quyền điện toán, quyền sở hữu dữ liệu và khả năng thích ứng vận hành vĩnh cửu.
Theo Dõi Dữ Liệu Đo Xa Công Nghệ Doanh Nghiệp & Dòng Vốn Hạ Tầng AI
Nền tảng Gemral Edge theo dõi việc phân bổ vốn thể chế, các tín hiệu mua sắm hạ tầng đám mây và đường cong ứng dụng công nghệ doanh nghiệp trên các thị trường toàn cầu theo thời gian thực.